Examen — Intelligence Artificielle
OC Informatique – Module IA
Invalid Date
Gymnase du Bugnon
IA-A-EX
Invalid Date
Nom :
Prénom :
Classe :
Note :
Partie A — Questions à choix multiples
Marquer la lettre correspondant à la réponse correcte dans la feuille de réponse. Une seule réponse par question.
Qu’est-ce que “l’effet IA” ?
- A La tendance à ne plus considérer comme vraiment “intelligent” une IA lorsqu’elle est dépassée par de nouveaux systèmes
- B L’engouement pour l’intelligence artificielle suite à la publication de ChatGPT
- C La perte de performance des élèves à cause de leur utilisation de l’IA
- D Les nouveaux effets spéciaux au cinéma rendus possibles grâce aux générateurs d’images
Qu’est-ce que le test de Turing ?
- A Un benchmark qui mesure les performances d’un LLM sur des tâches de raisonnement logique
- B Un test dans lequel un évaluateur humain doit distinguer une machine d’un humain lors d’une conversation textuelle
- C Un test de sécurité permettant de distinguer un humain d’un robot sur internet
- D Un test qui mesure la vitesse de calcul d’un ordinateur en résolvant des problèmes mathématiques
Laquelle des propositions ci-dessous n’est PAS une différence entre l’IA symbolique et l’IA connexionniste ?
- A L’IA symbolique utilise des règles logiques explicites, l’IA connexionniste apprend à partir de données
- B L’IA symbolique est interprétable, l’IA connexionniste est une « boîte noire »
- C L’IA symbolique cherche à automatiser des tâches cognitives, l’IA connexionniste cherchent à génerer du nouveau contenu
- D L’IA symbolique nécessite un expert humain pour encoder les connaissances, l’IA connexionniste peut apprendre seule à partir d’exemples
Quel est le plus gros inconvénient de l’IA symbolique ?
- A Elle nécessite de très grandes quantités de données pour fonctionner
- B Ses décisions sont inexplicables et difficiles à interpréter
- C Elle est trop lente pour traiter des requêtes en temps réel
- D Il est très coûteux d’encoder manuellement toutes les règles nécessaires pour des problèmes complexes du monde réel
Qu’appelle-t-on un hiver de l’IA ?
- A Une période de forte croissance des modèles génératifs
- B Un ralentissement dû au froid dans les data centers
- C Une période de désintérêt et de réduction des financements
- D La phase de fine-tuning d’un modèle pré-entraîné
À quoi sert le fine-tuning dans les LLM ?
- A À passer d’un modèle qui complète du texte à un modèle qui effectue une tâche spécifique
- B À pré-entraîner le modèle sur un grand volume de données textuelles
- C À réduire la taille du modèle pour le déploiement sur appareils mobiles
- D À augmenter la fenêtre de contexte du modèle
Qu’est-ce que la tokenisation dans un modèle de langage ?
- A La compression des données d’entraînement
- B La découpe du texte en unités élémentaires
- C L’encodage des paramètres du modèle en mémoire
- D La traduction automatique entre deux langues
En quoi consiste l’apprentissage dans un modèle de machine learning ?
- A À programmer explicitement toutes les règles permettant de résoudre le problème
- B À ajuster les paramètres du modèle pour minimiser l’erreur sur les données d’entraînement
- C À collecter et nettoyer les données avant de les fournir au modèle
- D À choisir l’architecture du réseau de neurones la plus adaptée au problème
Que fait l’algorithme de descente de gradient dans le machine learning ?
- A Il mesure la performance du modèle sur les données de test
- B Il réduit la dimensionnalité des données d’entrée pour accélérer l’entraînement
- C Il sélectionne les meilleures données d’entraînement pour un modèle donné
- D Il calcule le gradient de la fonction de perte et déplace les paramètres dans la direction qui la minimise
Partie B — Textes à trous
B.1 — Code à compléter
Associer chaque emplacement numéroté (1)–(5) du code Python ci-dessous à l’élément correspondant dans la banque de code. Inscrire la lettre dans la feuille de réponses.
Banque de code :
- A.
1.2 - B.
TinyLlama/TinyLlama-1.1B-Chat-v1.0 - C.
Tu es TinyLlama. Tu es toujours joyeux et tu crois en l'humanité - D.
300 - E.
Dis-moi TinyLlama, qu'est-ce que l'intelligence artificielle ?
from transformers import pipeline, AutoTokenizer
import torch

model_id = "_____________(1)_____________"

tokenizer = AutoTokenizer.from_pretrained(model_id)

gen = pipeline(
    "text-generation",
    model=model_id,
    tokenizer=tokenizer,
    device=-1,
    torch_dtype=torch.float32
)

messages = [
    {"role": "system", "content": "_____________(2)_____________"},
    {"role": "user",   "content": "_____________(3)_____________"}
]

prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)

result = gen(
    prompt,
    temperature=_____________(4)_____________,
    max_new_tokens=_____________(5)_____________,
    return_full_text=False,
)

print(result[0]["generated_text"])
B.2 — Choix inline
Pour chaque blanc numéroté, choisir la lettre correspondant au terme correct. Inscrire la lettre dans la feuille de réponses.
Un LLM génère du texte de manière (1) A. déterministe · B. probabiliste · C. binaire, en sélectionnant le prochain token selon une distribution de (2) A. probabilités · B. gradients · C. paramètres. La (3) A. précision · B. vitesse · C. température est un paramètre qui contrôle la diversité des réponses générées : une valeur élevée produit des sorties plus (4) A. créatives · B. précises · C. courtes.
Partie C — Relier
Dans chaque question de la partie C, vous devez associer chaque lettre à gauche à un unique chiffre à droite. Notez vos réponse dans la feuille de réponse.
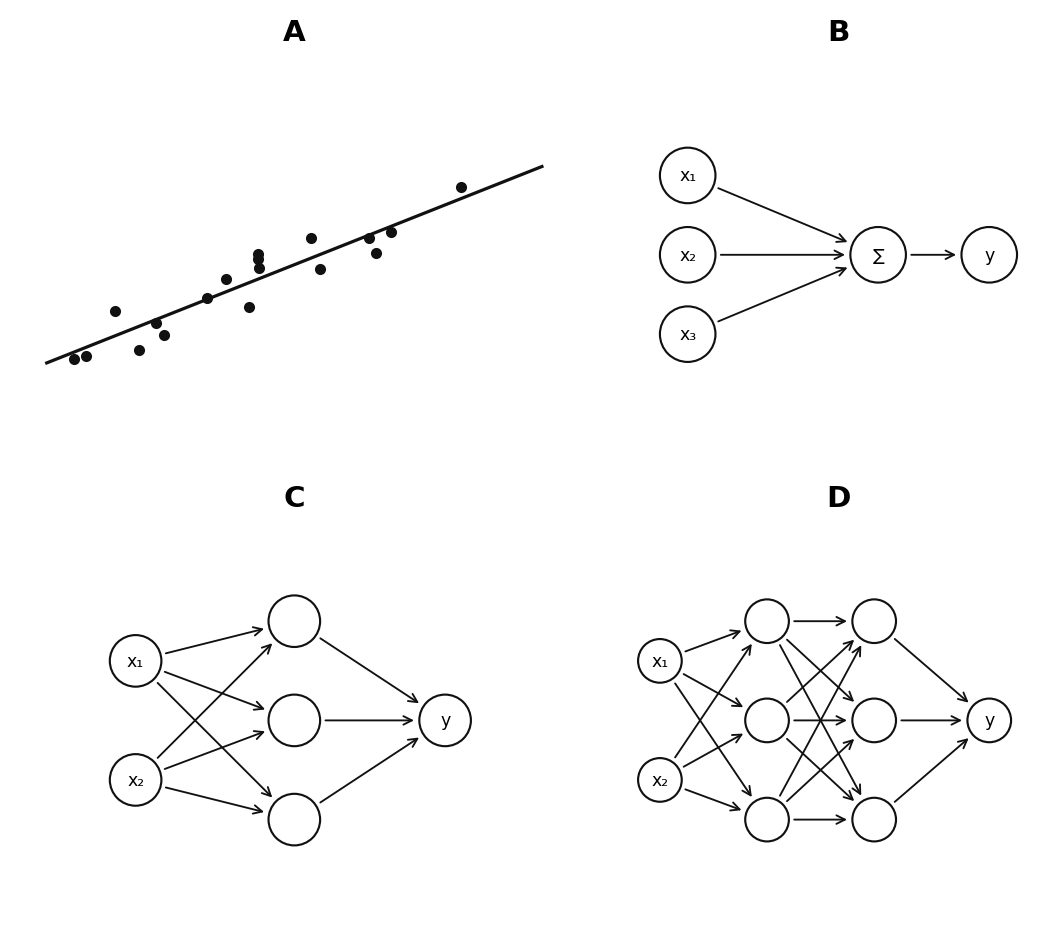
À chaque diagramme (A–D) de la Figure 1, associer le modèle de machine learning correspondant (1–4).
- 1 Neurone simple
- 2 Couche de neurones
- 3 Régression linéaire
- 4 Deep learning
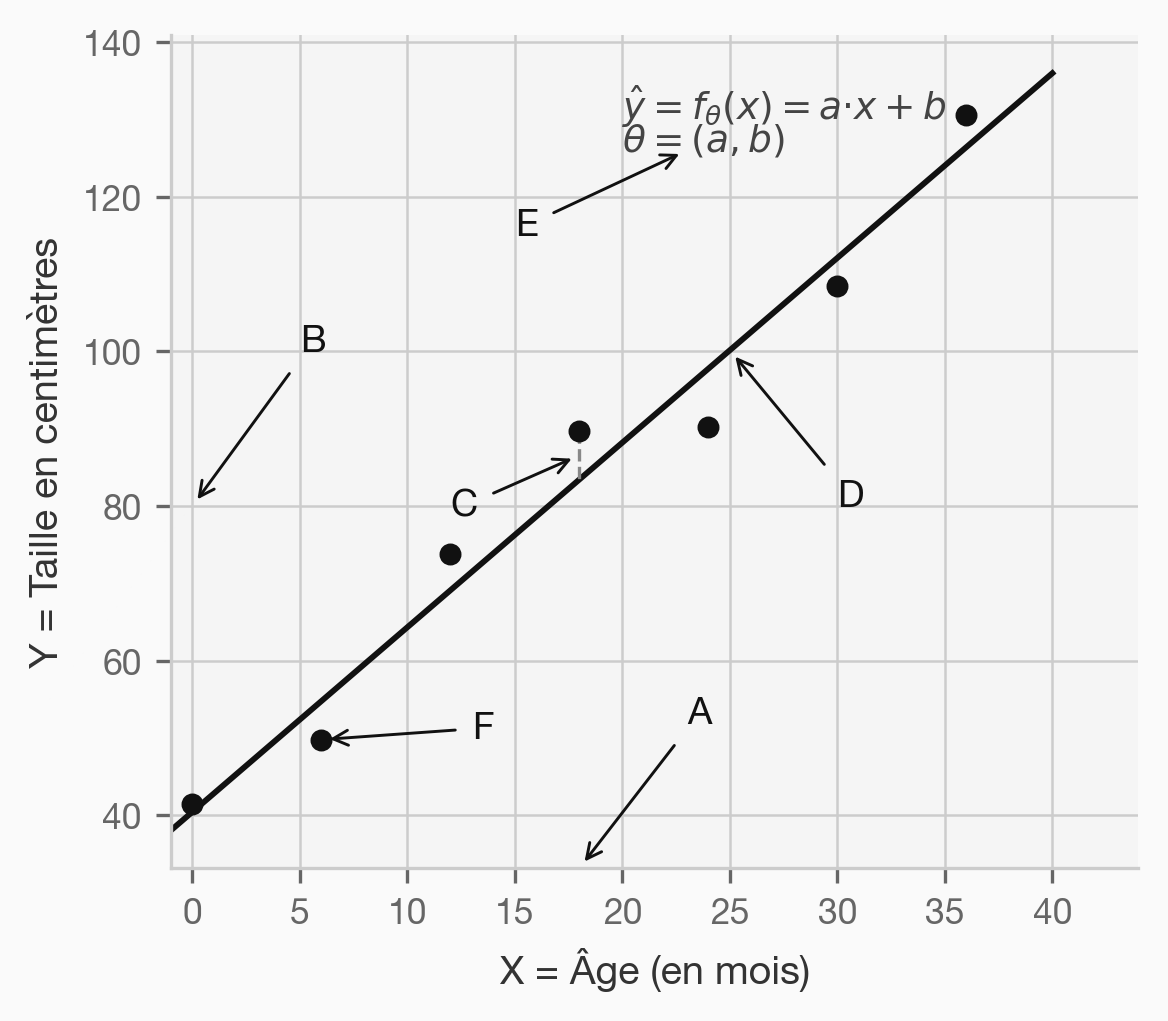
Dans la Figure 2, identifier les différents éléments annotés (A–F) d’une modélisation par régression linéaire de la taille d’un enfant de sa naissance jusqu’à ses 36 mois.
- 1 Donnée d’entrée du modèle (Input)
- 2 Donnée de sortie (Output) du modèle correspondant à l’entrée
- 3 Représentation du modèle
- 4 Paramètres du modèle
- 5 Donnée d’entraînement
- 6 Erreur du modèle commise sur une donnée
On considère le texte “Bonjour Monde”. Faire correspondre chaque concept (A–D) à la transformation correspondante (1–4).
- A Score de sortie logit
- B Tokenisation BPE
- C Embedding
- D Tokenisation par caractère
- 1
['B','o','n','j','o','u','r',' ','M','o','n','d','e'] - 2
['Bon','jour',' Mon','de'] - 3
[[0.23, −0.41, …], [0.87, 0.05, …], [−0.12, 0.63, …], [0.44, −0.31, …]] - 4
[−2.1, 3.4, 0.7, …]
Faire correspondre chaque étape de pré-traitement des données à un des exemples :
- A Filtrage
- B Dé-duplication
- C Réduction des données de vie privée
- D Tokenisation
- 1 “Moi,
Martine Martinélèveélève de la 1M25du Gymnase du Bugnon, je déteste Metallica.” - 2 “Metallica est un groupe” => [28, 1, 3, 2, 5, 1, 87]
- 3 “Metallica est un groupe qui a ses origines …
Metallica est un groupe qui a ses origines …” - 4 “Metallica est un
!x#X@de bon groupe.”
Expliquer la signification de chaque partie de l’identifiant suivant de modèle Qwen/Qwen3-0.6B-Base :
- A
Qwen/ - B
Qwen3 - C
0.6B - D
Base
- 1 Nom et version du modèle
- 2 LLM de base sans fine-tuning
- 3 Nombre de paramètres
- 4 Publié par Alibaba
Relier chaque élément de la colonne de gauche à la définition correspondante dans la colonne de droite.
- A Température
- B Token
- C Fine-tuning
- D Embedding
- 1 Unité élémentaire de texte traitée par un LLM
- 2 Représentation d’un mot sous forme de vecteur numérique
- 3 Paramètre contrôlant la diversité des réponses
- 4 Adaptation d’un modèle pré-entraîné à une tâche spécifique
Relier chaque technique de prompt engineering à l’exemple de prompt correspondant
- A RCO (Rôle, Contexte, Objectif)
- B Prompting inversé
- C Chain-of-Thought (CoT)
- D [Sujet] + [Détails] + [Style] + [Composition] + [Lumière] + [Qualité / Technique]
- 1 “Aide-moi à choisir un endroit où aller en vacances cet été. Pose-moi d’abord des questions sur mes goûts.
- 2 “Un gymnasien en train de regarder un couché de soleil sur une plage. T-shirt troué, sac de rando à côté. Atmosphère nostalgique. Vu de dos. lumière douce. Stock.”
- 3 “Je suis un gymnasien fauché de Lausanne. Tu es Indiana Jones. Aide-moi à transformer mes vacances d’été en aventure.”
- 4 “Quel est LE meilleur endroit où passer ses vacances en été 2026 ? Avant de donner une réponse, explique-moi étape par étape ton raisonnement.”
Partie D – Ordonner
Numéroter les étapes du cycle de vie d’un LLM dans l’ordre chronologique (1 = première étape).
- A Fine-tuning
- B Collecte et filtrage des données d’entraînement
- C Pré-entraînement sur corpus général
- D Distillation et quantification
- E Évaluation sur benchmarks